Dacă ai un site sau un blog și nu vrei ca textele tale să fie folosite la antrenarea modelelor AI, până acum trebuia să blochezi pe rând roboții fiecărei companii: GPTBot pentru OpenAI, Google-Extended pentru Google, ClaudeBot pentru Anthropic și așa mai departe. OpenAI, Google, Microsoft și Anthropic au anunțat că vor respecta un singur semnal comun, scris tot în fișierul robots.txt. Propunerea a fost publicată vineri, 30 octombrie, de Kevin Kelley, de la Anthropic, ca document de lucru la IETF, organizația care stabilește standardele internetului.
Semnalul se adaugă cu două rânduri, dar are limite importante: e o preferință, nu o barieră, companiile îl vor respecta abia din 2027, iar ce a fost deja folosit la antrenare nu se mai poate scoate din modele.
Cum arată regula
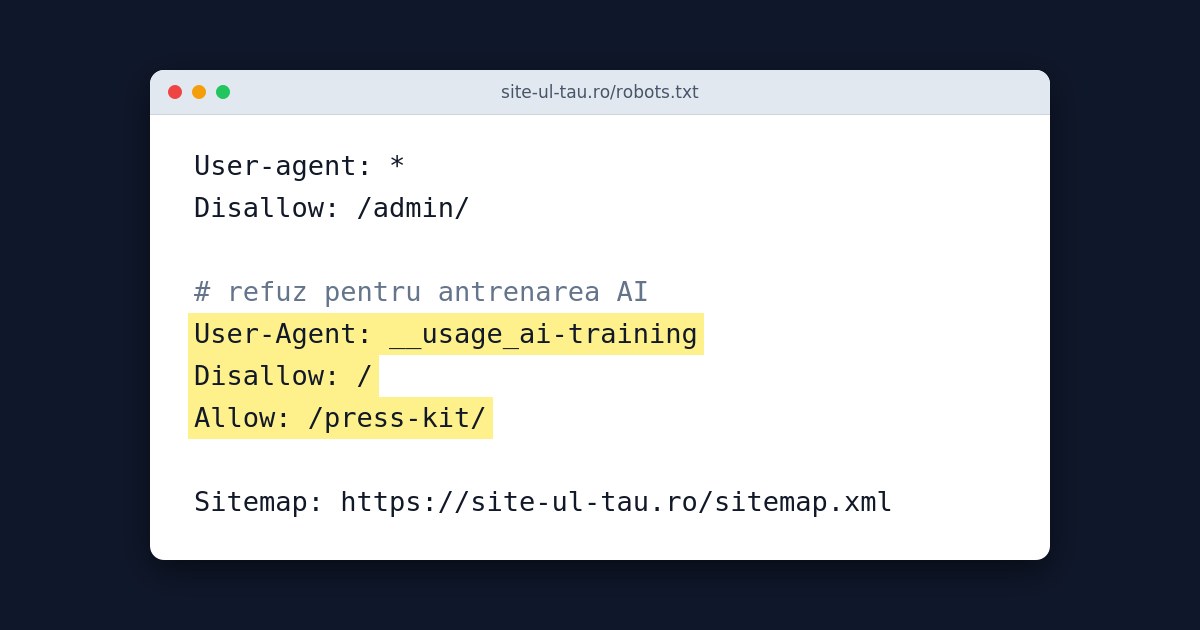
Noul semnal e un nume special, __usage_ai-training, cu două liniuțe jos la început, folosit ca și cum ar fi un robot. Pentru a refuza antrenarea pe tot site-ul, adaugi în robots.txt:
User-Agent: __usage_ai-training
Disallow: /
Poți face și excepții. Exemplul din propunere refuză antrenarea pe tot site-ul, mai puțin pe pagina pentru presă:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Regulile funcționează la fel ca cele obișnuite din robots.txt: o cale cu Disallow înseamnă „nu folosi pentru antrenare”, una cu Allow înseamnă acord explicit.
Capcana: „User-agent: *” nu se pune
Multe site-uri au deja un grup general, User-agent: *, care se aplică tuturor roboților. Propunerea spune explicit că acest grup nu se aplică noului semnal. Chiar dacă blochezi tot site-ul pentru toți roboții, asta nu înseamnă, pentru acest mecanism, că refuzi antrenarea. Dacă nu există un grup separat pentru __usage_ai-training, se consideră că nu ți-ai exprimat nicio preferință.
Alegerea e voită: blocarea generală are de obicei alte motive, cum ar fi paginile de administrare sau cele duplicate, și nu ar trebui interpretată automat ca o decizie despre AI.
Când îl respectă fiecare companie
| Compania | De când | Ce trebuie știut |
|---|---|---|
| Anthropic | a început implementarea | acoperirea tuturor serviciilor „va lua timp”; regulile pentru ClaudeBot rămân valabile |
| OpenAI | „în lunile următoare” | fără o dată fixă; regulile pentru GPTBot rămân valabile |
| Microsoft | 1 februarie 2027 | după 1 martie 2027 nu mai tratează etichetele NoArchive și NoCache ca refuz al antrenării |
| începutul lui 2027 | dacă nu ai o regulă separată pentru Google-Extended, semnalul comun e tratat ca un refuz Google-Extended | |
| Meta | neclar | susține ideea unui semnal comun, dar nu a spus că îl va respecta |
Apple, Amazon, xAI și Perplexity nu au făcut deocamdată niciun anunț.
Ce nu face semnalul
- Nu te scoate din Google sau Bing. Semnalul privește doar antrenarea. Google spune că paginile rămân în căutare, iar Microsoft că poziția în Bing nu se schimbă.
- Nu oprește răspunsurile AI bazate pe pagina ta. Când un asistent caută pe internet și îți citează pagina într-un răspuns, nu e vorba de antrenare. Microsoft introduce pentru asta o setare separată, pe fiecare pagină, pentru Bing, Copilot și Microsoft 365. Dacă refuzi și această folosire, site-ul tău va apărea mult mai rar în răspunsurile AI ale Microsoft.
- Nu blochează accesul. Roboții pot vizita în continuare paginile. Dacă vrei să-i oprești de tot, ai nevoie de reguli pe server sau de servicii precum Cloudflare.
- Nu are efect retroactiv. Textele colectate înainte să adaugi regula sunt deja în seturile de antrenare.
- Nu e obligatoriu. Respectarea lui e voluntară, iar acordurile private dintre un site și o companie AI au prioritate. Nu există un mecanism prin care să obligi o companie să-l respecte.
Ce faci acum, pas cu pas
- Deschide fișierul
robots.txtdin rădăcina site-ului (îl vezi laadresa-ta.ro/robots.txt). Pe WordPress, îl poți edita de obicei din modulul de SEO pe care îl folosești, de exemplu Yoast sau Rank Math. - Adaugă grupul nou, separat de cel cu
User-agent: *, cu un rând gol între grupuri. - Păstrează regulile existente pentru GPTBot, Google-Extended sau ClaudeBot. Până în 2027 sunt singurele pe care companiile le respectă sigur.
- Decide ce faci cu Google-Extended. Dacă vrei ca Gemini să se antreneze pe site-ul tău, dar ceilalți nu, păstrează o regulă separată prin care permiți explicit accesul pentru Google-Extended.
- Dacă folosești NoArchive sau NoCache pentru a te feri de AI-ul Microsoft, adaugă noul semnal înainte de 1 martie 2027.
- Verifică rezultatul deschizând
robots.txtîn browser. O greșeală de scriere în numele semnalului face ca regula să fie ignorată fără niciun avertisment.
Ar trebui să-l folosești?
Depinde de ce aștepți de la site. Un blog personal sau o publicație care trăiește din trafic are motive să refuze antrenarea: textele tale ajută un model care apoi răspunde direct cititorilor, fără ca aceștia să mai ajungă pe site. Pe de altă parte, un magazin sau o firmă care vrea să fie recomandată de asistenții AI poate avea interesul opus. Vestea bună e că, pentru prima dată, decizia se poate lua cu o singură regulă, nu cu o listă de roboți care se schimbă de la o lună la alta.
Google spune că propunerea se potrivește cu Codul de bune practici al Uniunii Europene pentru modelele AI de uz general, care recunoaște robots.txt drept principalul mod prin care editorii își exprimă preferințele. La elaborarea ei au contribuit și Financial Times, BBC, Bertelsmann și Consiliul Editorilor Europeni. Rămâne ca grupul de lucru al IETF să o transforme într-un standard. Deocamdată, la ultima întâlnire, din 21 octombrie, unul dintre coordonatori spunea că „nu s-a declarat încă un consens pe nimic”.
Surse: documentul IETF draft-kelley-aipref-training-preference-signal-00 (30 octombrie: definiția semnalului, exemplul de configurare, regula pentru „User-Agent: *”, lipsa preferinței în absența grupului), The Next Web (data publicării, angajamentele OpenAI, Google și Microsoft, setarea pentru răspunsurile AI, contextul european, contribuția editorilor), Martin Cid Magazine (31 octombrie: declarațiile Anthropic și Meta, comportamentul Google-Extended, ce nu acoperă semnalul), 1023 Jack (datele Microsoft, pașii de configurare, statutul documentului la IETF, declarația de la întâlnirea din 21 octombrie).
Fii primul care comentează acest articol!